从 VLA 到 VSLA
现代视觉-语言-动作(VLA)策略已经证明,大型多模态模型可以把图像、语言与机器人状态直接映射为动作。 当任务相关证据在视觉上持续存在时,这一范式工作得很好:杯子一直在桌上,抽屉开着,相机可以在许多控制周期里反复观察到这些事实。 近期一些系统开始引入音频,但在多数情况下,声音仍被当作动作之前的一次性输入,或者主要用于语音理解。
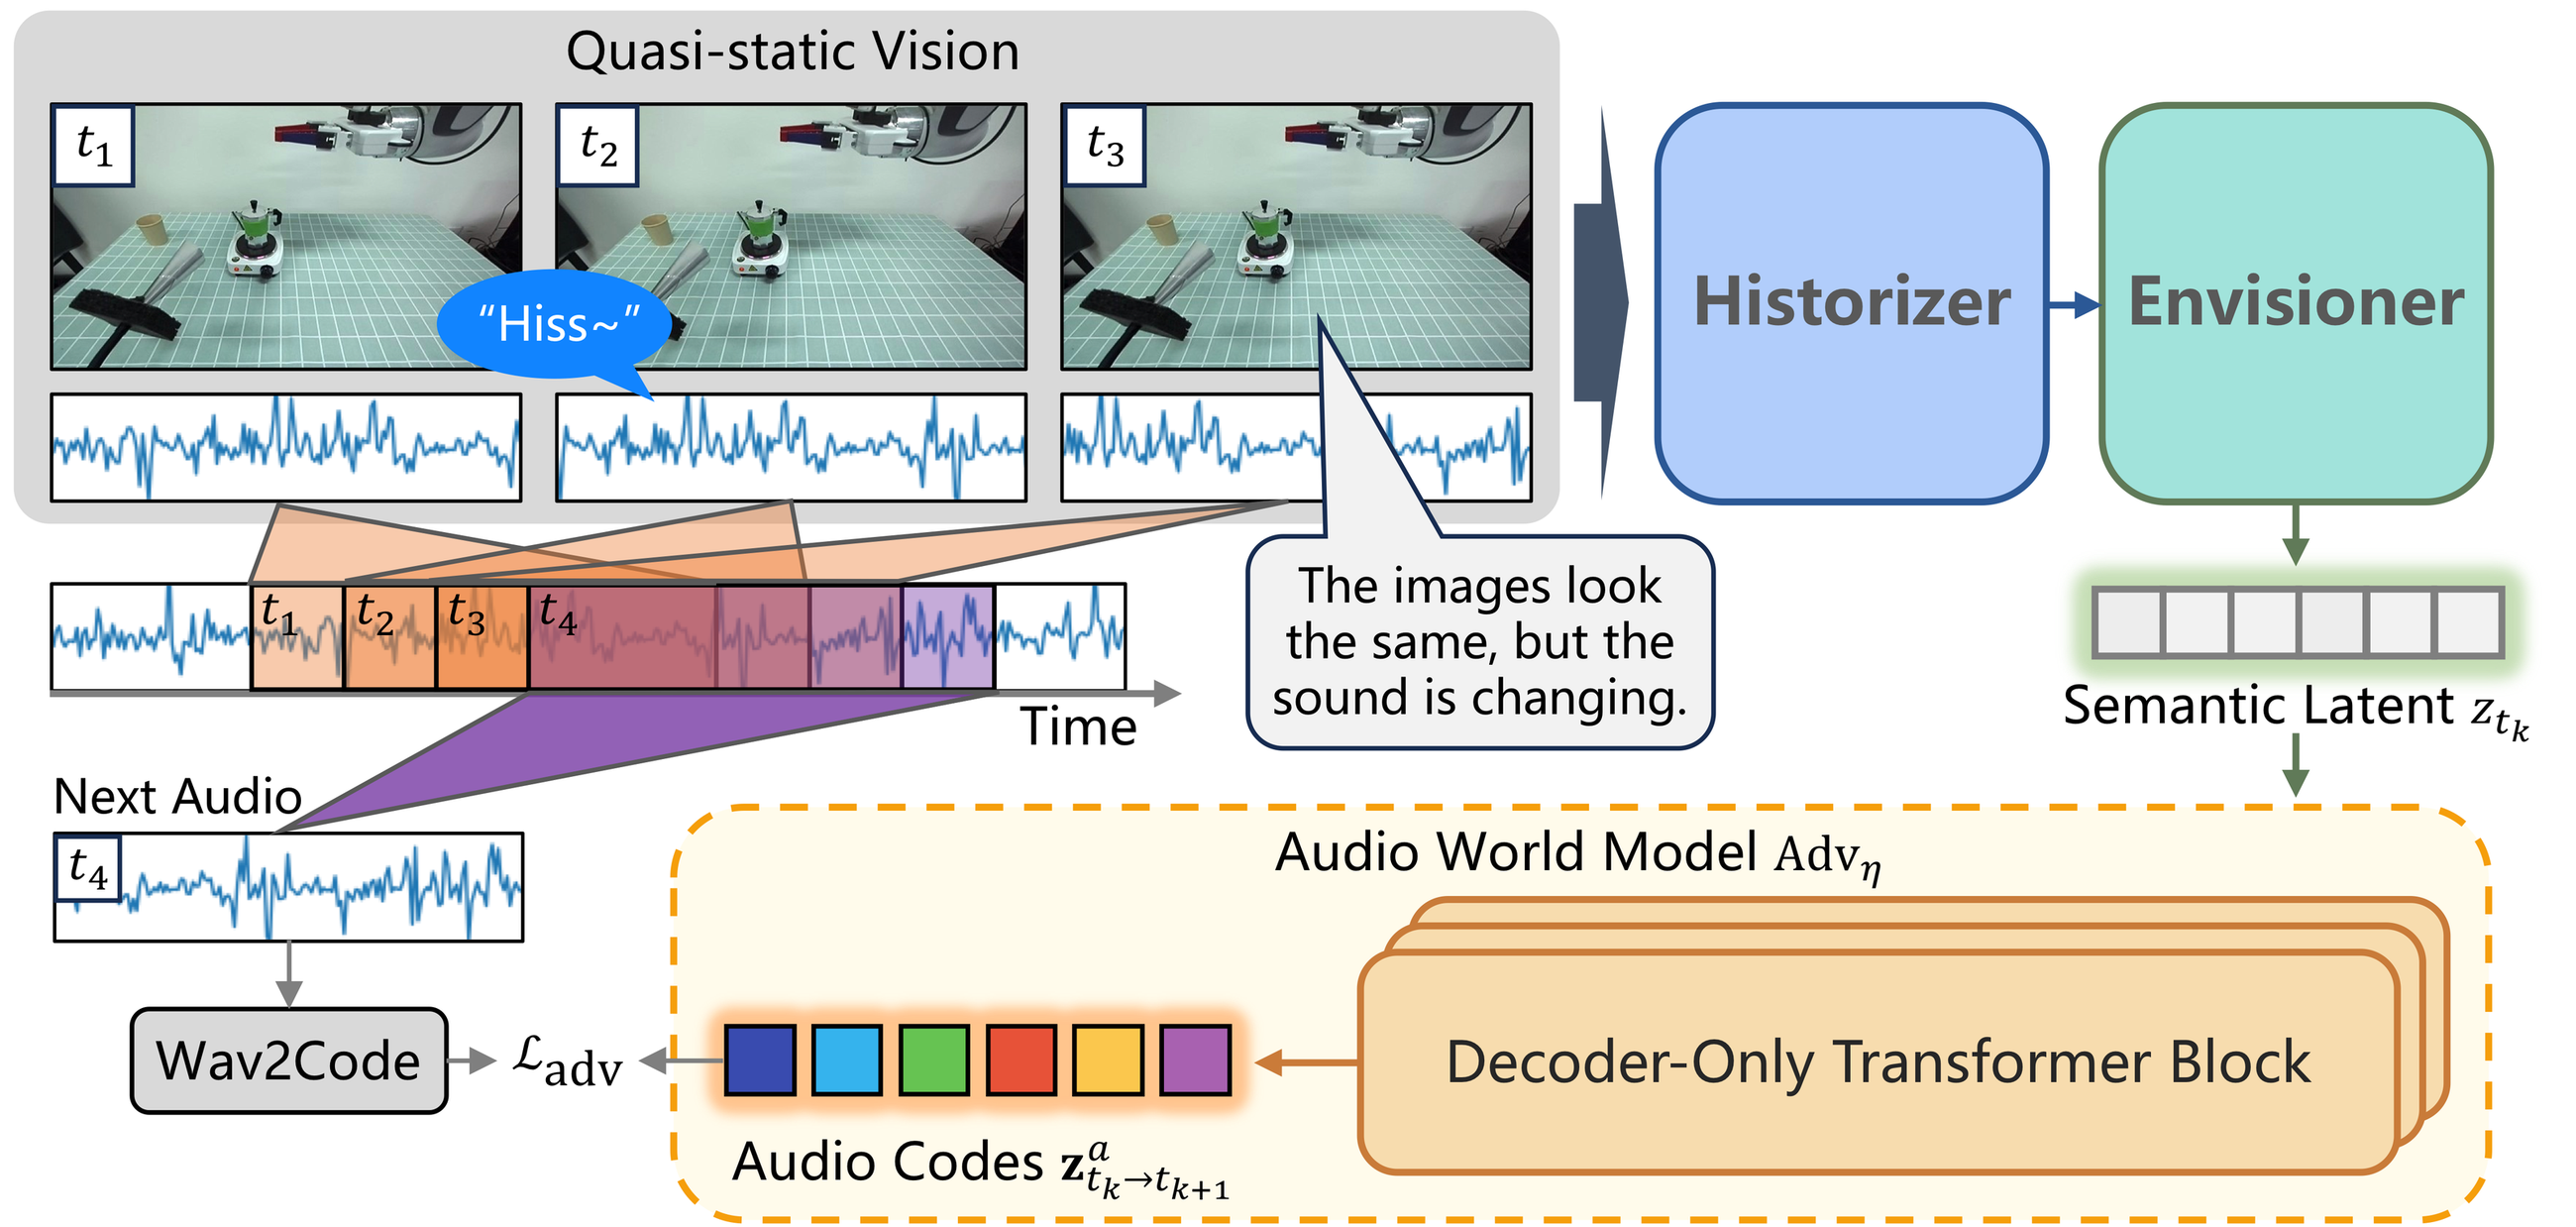
声音中心操作则完全不同。 这里的关键证据可能是一声提示音、一次碰撞咔哒、煮水声的细微变化,或者一句口头确认的语调。 这些线索往往短暂、不可重复,只有当机器人在执行过程中的正确时刻聆听时才具有意义。 问题不只是"多加一个模态",而是音频在时间上的分布方式与视觉截然不同。 在更广阔的具身智能与物理AI 图景中,听觉是告诉智能体事情在何时发生的模态,而不只是它在哪里。
现有的把声音接到 VLA 上的做法往往过于静态。 自动语音识别会丢弃非语音线索与韵律信息;而"波形转图像"适配器则把时间信号压扁成一张静态快照。 当线索很短、发生在两次策略推理之间,或者任务依赖声音如何演变而非某个孤立事件时,这两种做法都变得脆弱。
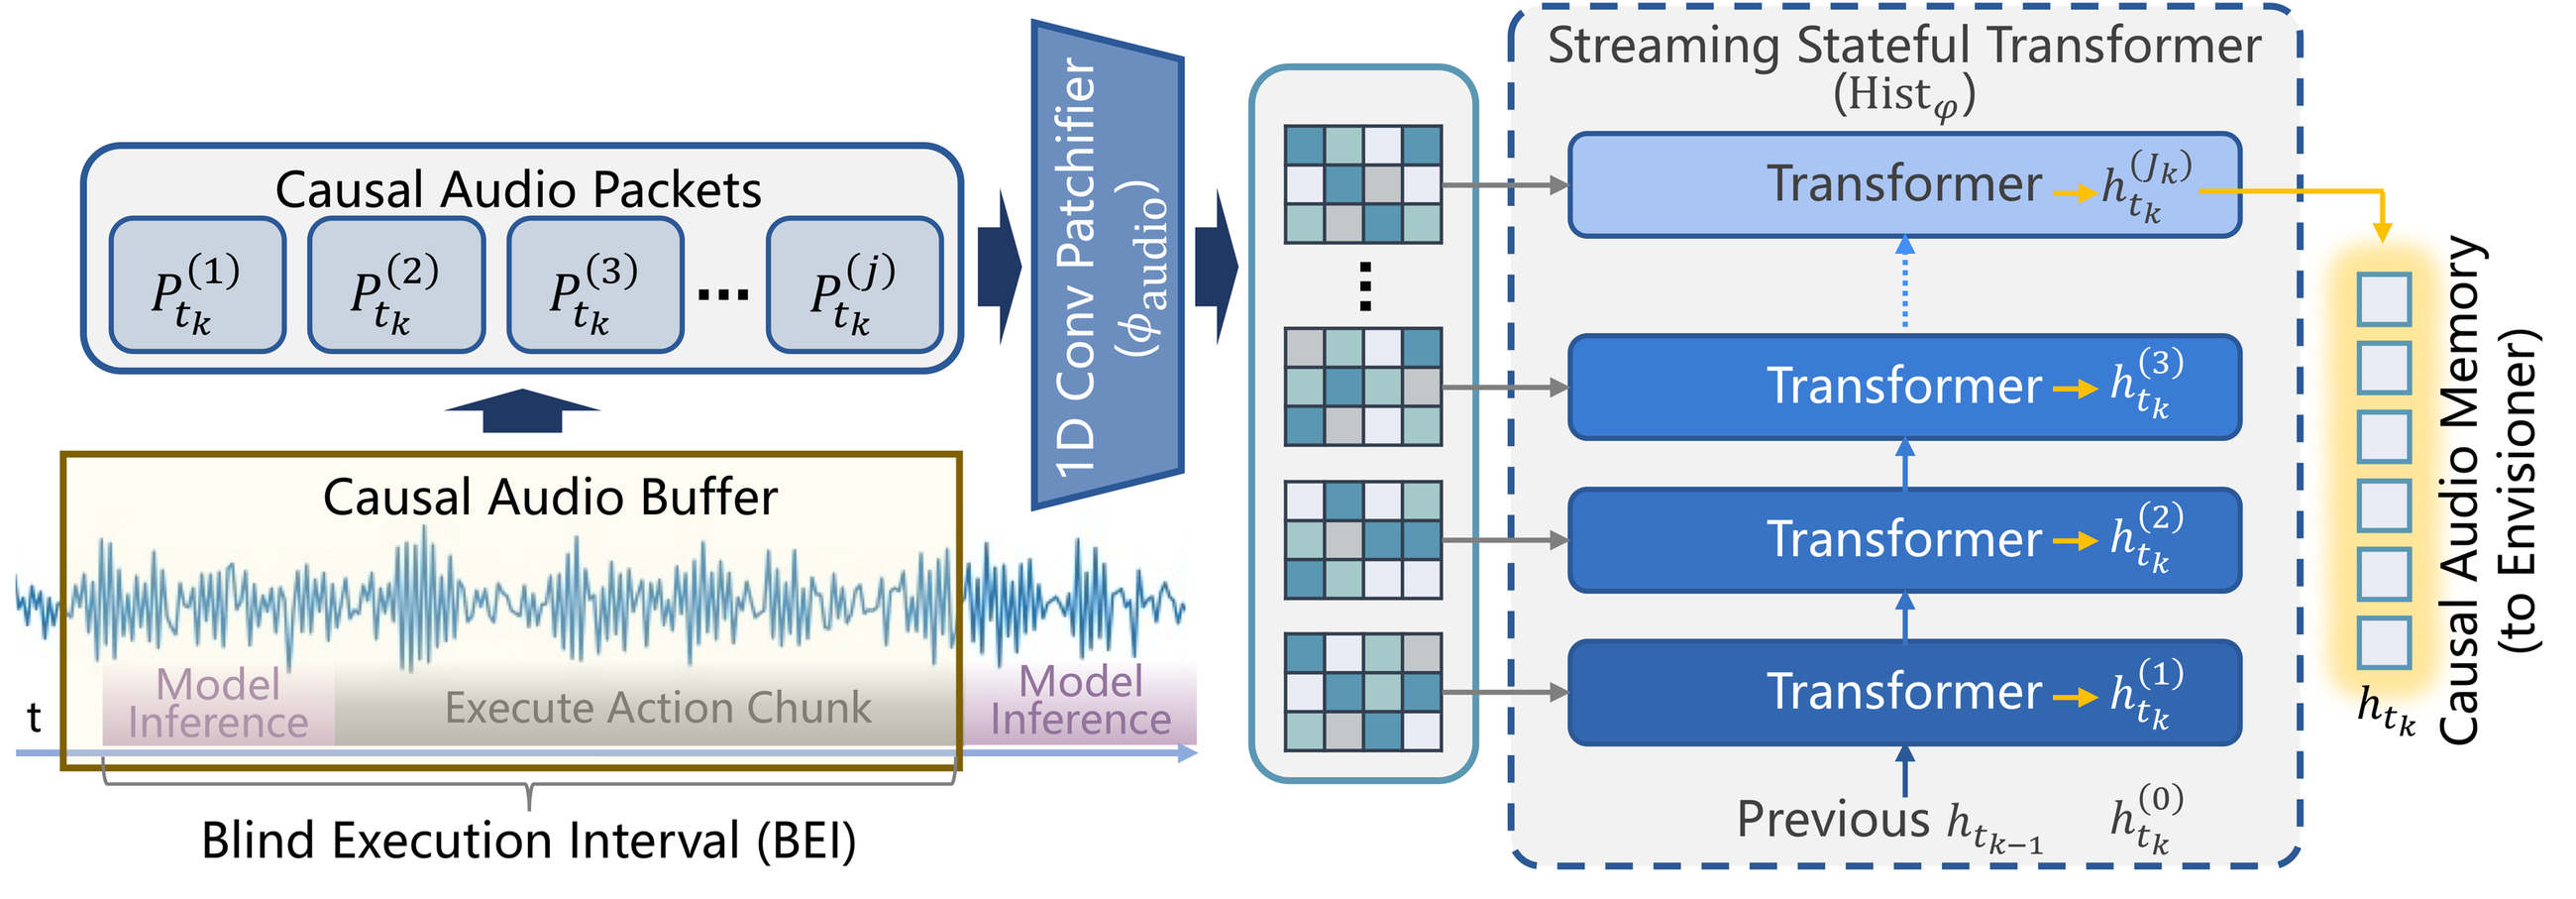
这也正是现代动作分块(action chunking)成为问题的地方。 大型策略通常一次预测一个动作块,并以开环方式执行以保持运动平滑。 在这一区间内,新的观测无法改变已经发出的指令序列。 对声音中心任务而言,这形成了一个结构性的盲区:一段很短的线索可能在下一次决策看到它之前就已经发生并消失。 我们称之为盲执行间隔(Blind Execution Interval)。
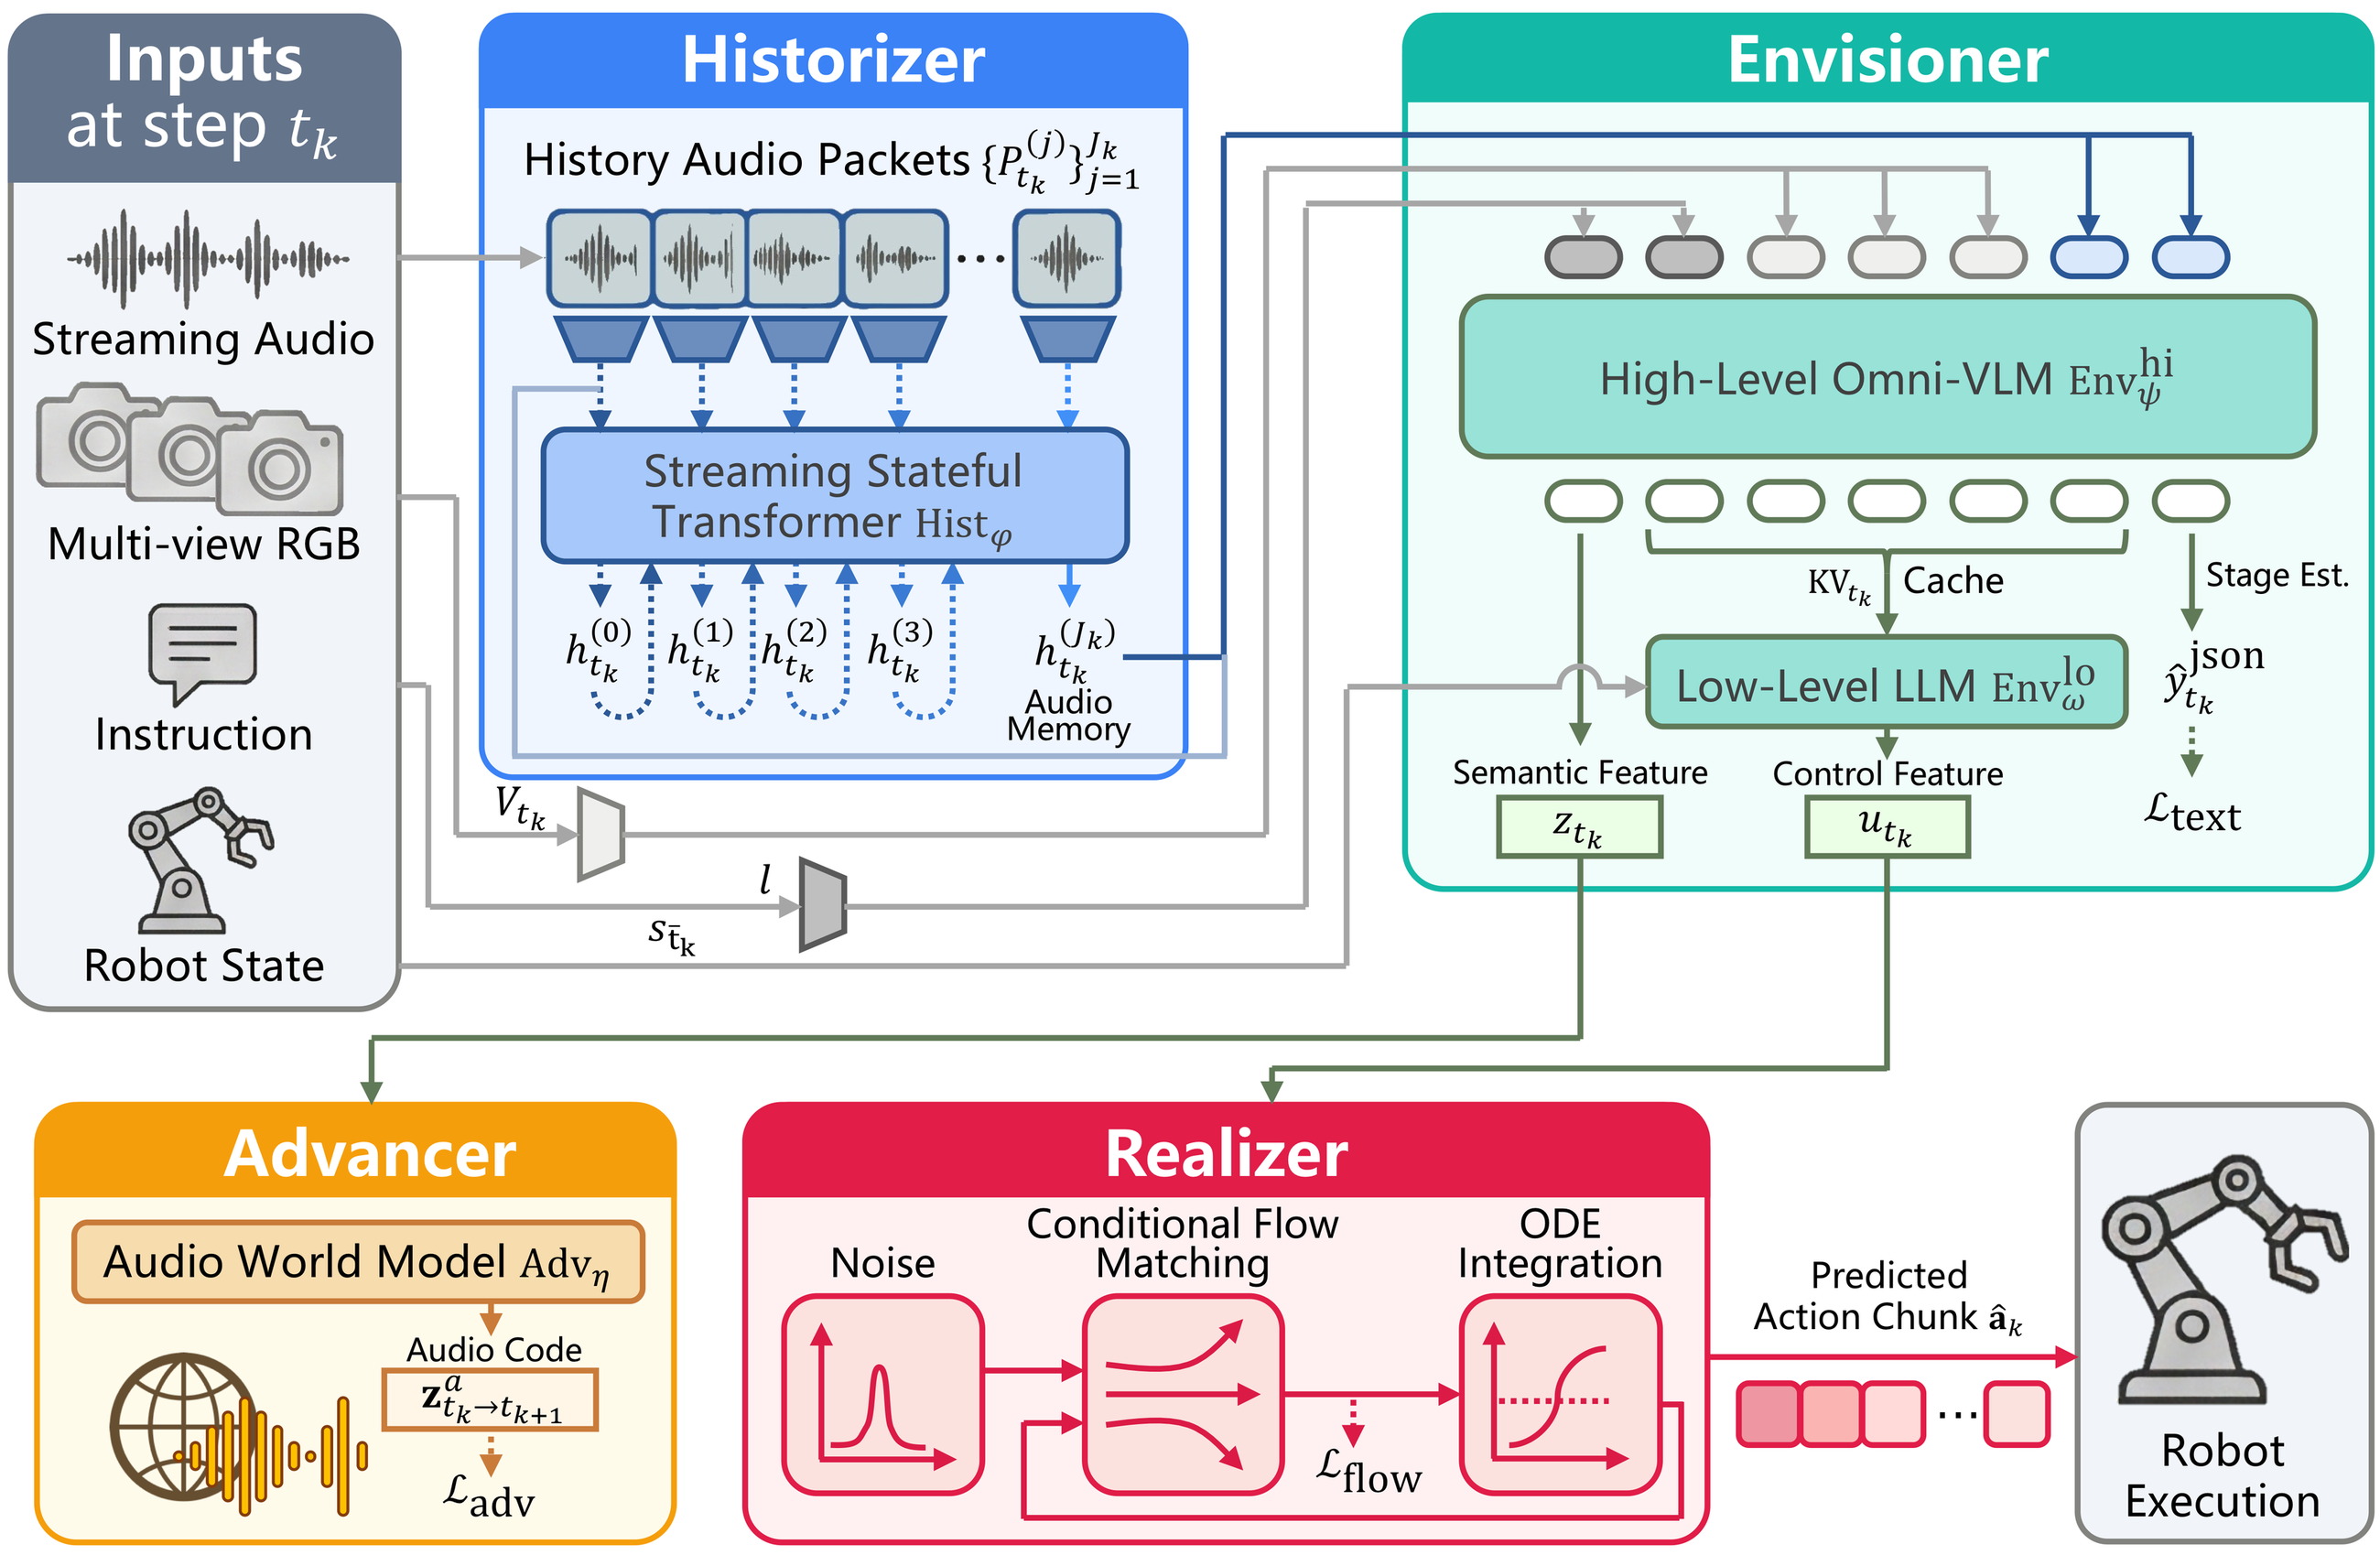
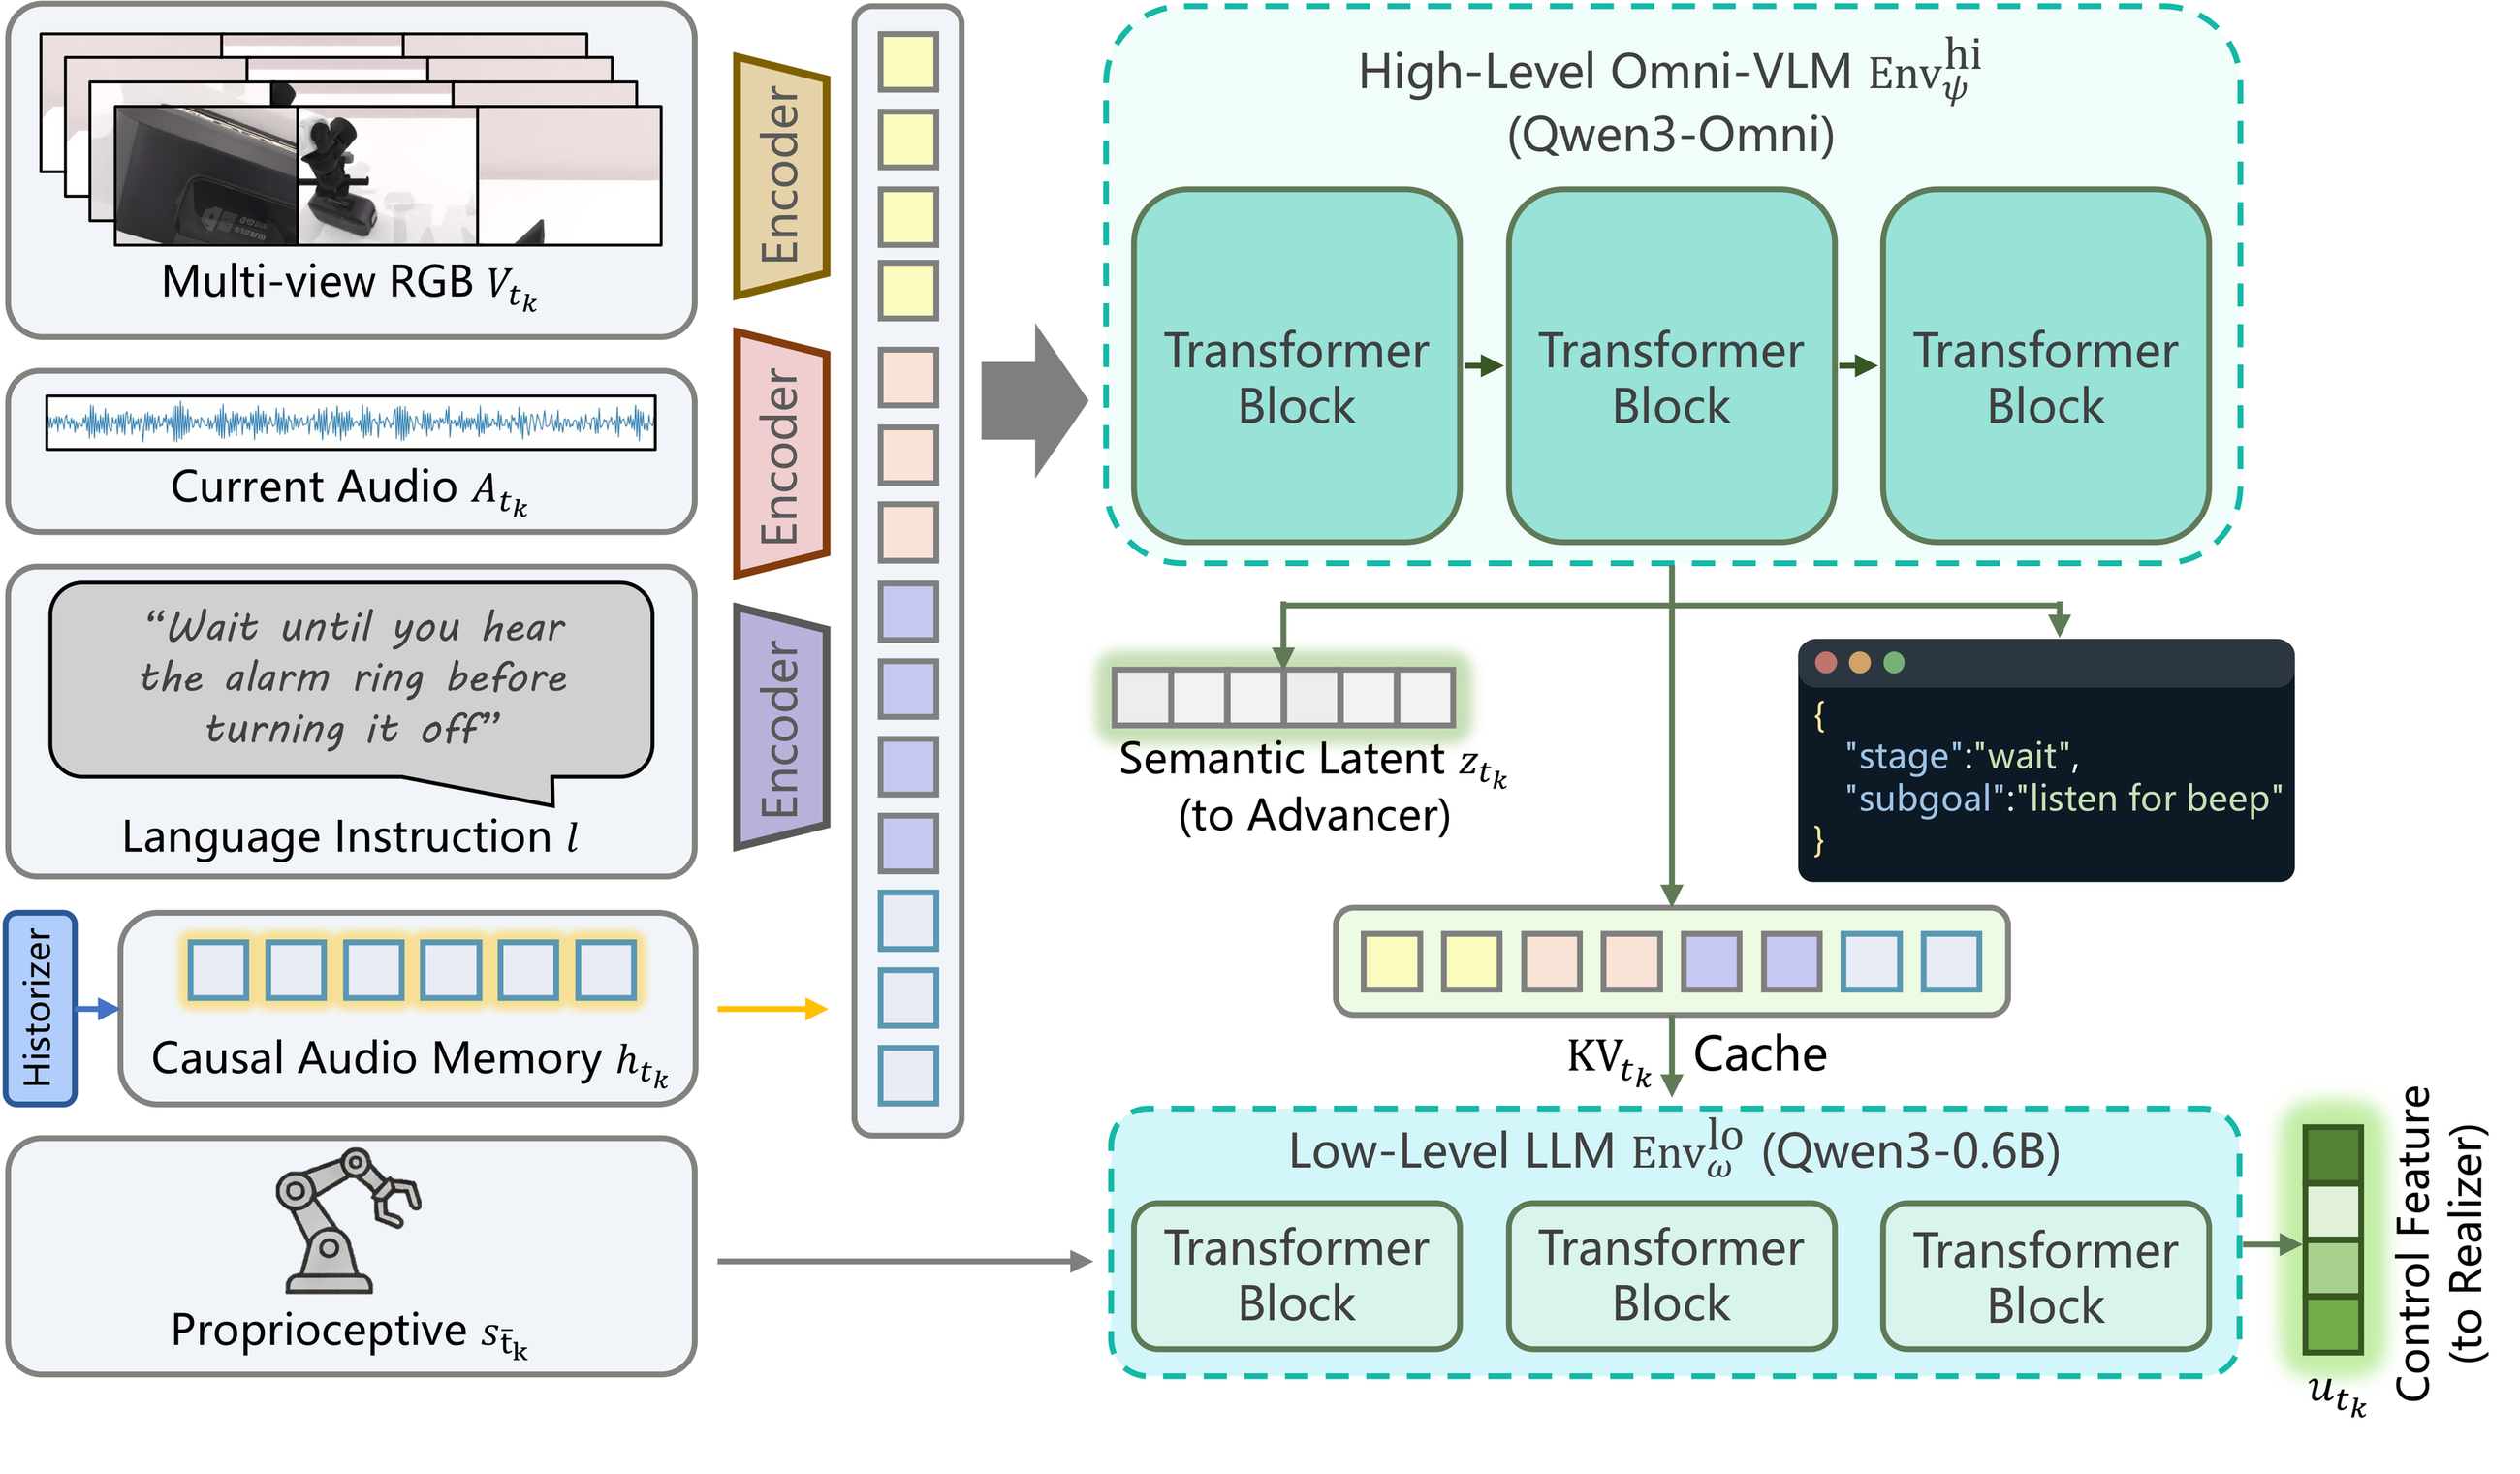
这些局限促使我们提出视-声-语言-动作(VSLA)范式。 VSLA 把 VLA 从"看见并行动"扩展为"看见、听见、记住并反应",并且是在延迟、异步的控制条件下。 本文用 HEAR 实例化这一范式,并配套一个预训练数据集与一个声音因果评测基准,使整条流程可以被一致地训练与评估。
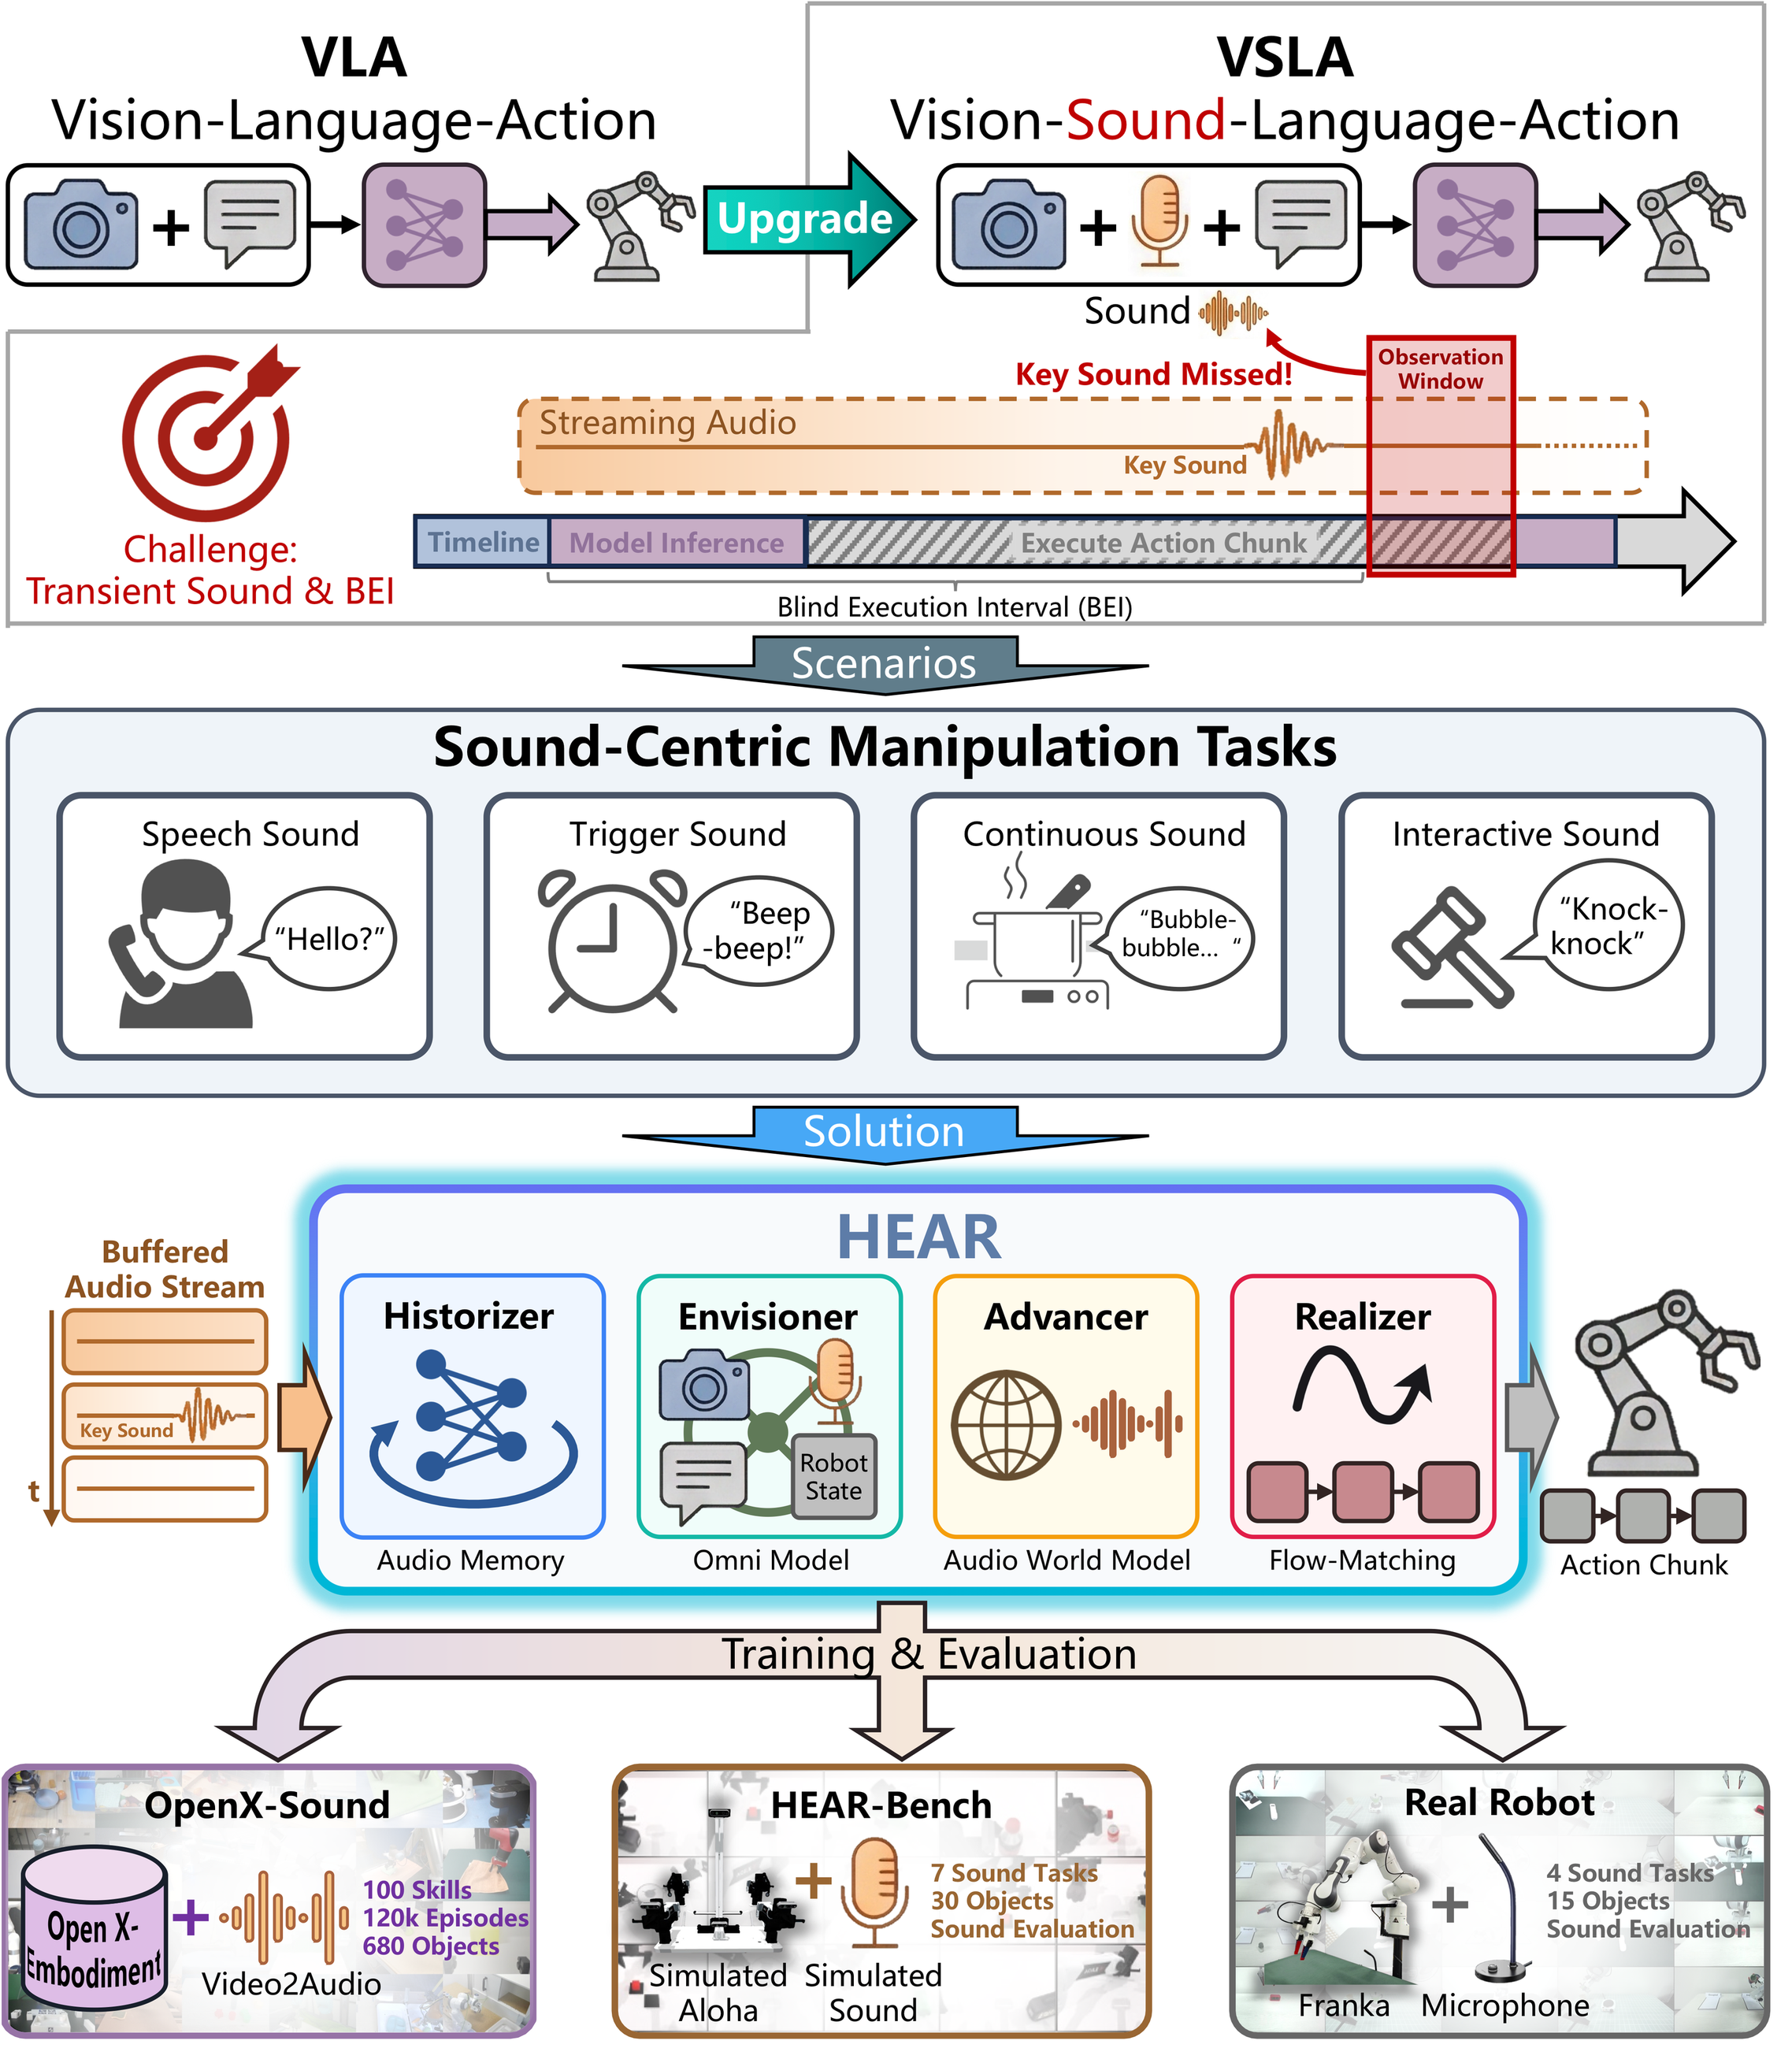
HEAR 把操作任务从"视觉主导"重新定义为"声音因果":策略必须保留稍纵即逝的声学证据、对多感官上下文进行推理,并且只在正确的声音条件真正发生之后才动作。